
Zero-dependency neural network framework in JavaScript. Autograd, tensors, convolution, layers, optimizers, and training loops, all written by hand. Browser and Node.js.
零依赖的神经网络框架。从张量运算到自动微分,从层到训练循环,全部手写。 同一份代码在浏览器和 Node.js 里都能跑。
Live demo · XOR example · Regression example · English site · ★ Star on GitHub


XOR          100.0% 准确率      高斯簇       100.0% 准确率
螺旋数据集    100.0% 准确率      线性回归     w=2.511(真值 2.5)
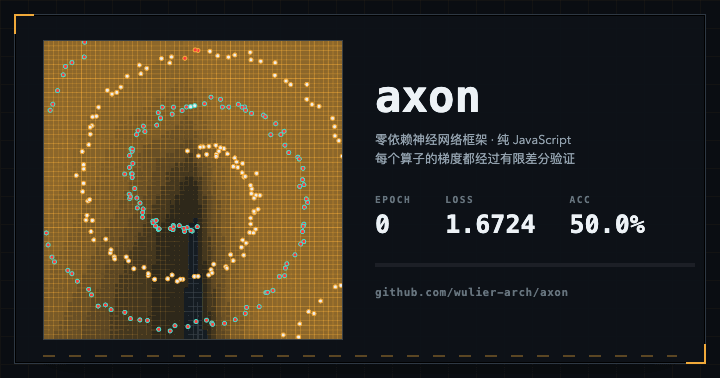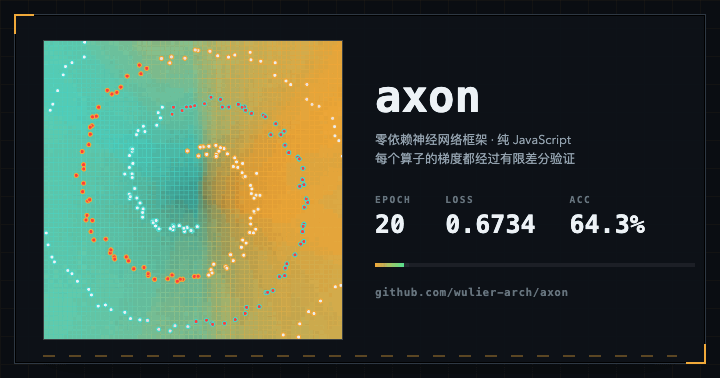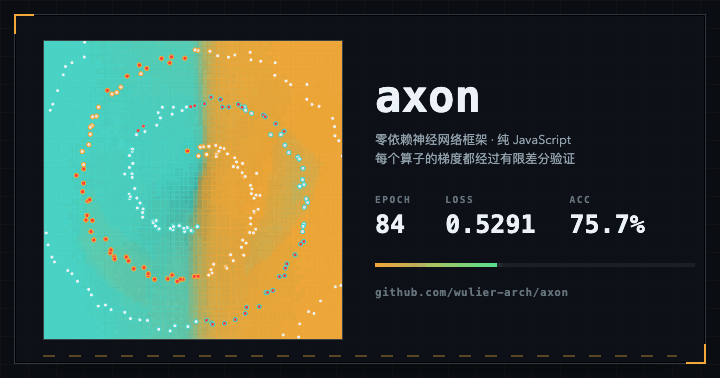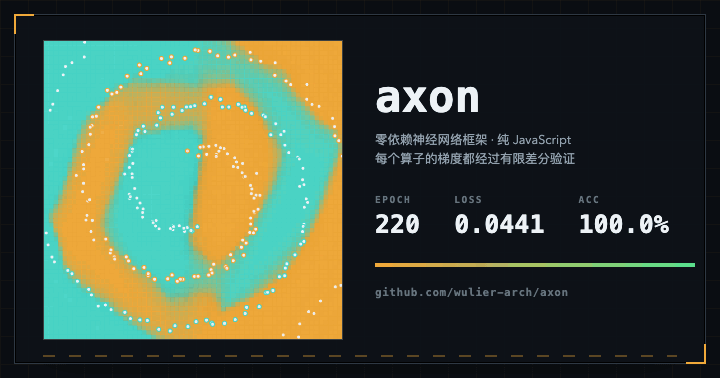
上面这段动画是用 axon 本身跑出来的:两层 ReLU 网络 + Adam,220 个 epoch 后损失降到 0.05 以下、准确率 100%,全程零依赖。画面里红色的点是分错类的样本——早期它们很多,随训练推进逐渐归零。
在浏览器里看神经网络学习:决策边界随着训练推进从斑驳逐渐变干净。整个 demo 没有打包步骤——它直接 import 了 src/ 里的框架源码,这在浏览器里就能跑,本身就是零依赖设计目标的证明。
如果想从更小的例子开始,可以打开两个无需安装、无需打包器的交互示例: XOR 分类器 和 线性回归。
现有的 JS 深度学习库基本是 TensorFlow.js / ONNX 的封装。你没法在不装依赖的前提下读懂它们的反向传播,也没法在浏览器里断点进去看梯度是怎么流回去的。
axon 想做的是另一件事:把这件事摊开给你看。
- 零依赖 —— 不装任何东西,克隆下来就能跑
- 梯度可验证 —— 每个算子都自带有限差分对照,梯度错了立刻暴露,不是"跑起来没报错就算对"
- 能真的训练 —— 不只是算子库,层、优化器、训练循环一应俱全
- 双端同构 —— 浏览器里能训练,Node 里能训练,同一份代码
npm install github:wulier-arch/axon第一次使用可以从 5 分钟入门指南、 完整 API 参考、Node 示例 和 浏览器示例 开始。
也可以不用安装,直接克隆——本项目零依赖,src/ 就是全部:
git clone https://github.com/wulier-arch/axon.git
cd axon && npm test训练一个神经网络,11 行:
import { Linear, Sequential, Adam, Trainer, crossEntropy, accuracy, makeSpiral } from "axon-net";

const { x, y } = makeSpiral({ samples: 300 });     // 程序生成的数据集

const model = new Sequential()
  .add(new Linear(2, 32, { activation: "relu", seed: 1 }))
  .add(new Linear(32, 2, { seed: 2 }));

const trainer = new Trainer({
  model,
  optimizer: new Adam({ lr: 0.01 }),
  lossFn: crossEntropy,
  metricFn: accuracy,
  epochs: 400,
  batchSize: 32,
});

trainer.fit(x, y, y);
console.log(trainer.history.at(-1));
// { epoch: 399, loss: 0.0248, metric: 1 }
每一层都指定了
seed。随机初始化下准确率会有波动——不固定种子的话, 你可能跑到 94% 而不是 100%,那不是 bug。想看稳定的 100%,就用上面这份代码原样跑。
自己实现反向传播,7 行:
import { Tensor, mul, backward, checkGradient } from "axon-net";

const x = Tensor.variable([2, 3], [2]);
backward(mul(x, x).sum());
console.log(x.grad);           // Float64Array [ 4, 6 ]   ← d(x²)/dx = 2x

const r = checkGradient(() => mul(x, x).sum(), [x]);
console.log(r.report, r.passed); // 梯度已用有限差分交叉验证不是"跑起来没报错",而是收敛到接近最优。npm run benchmark 可复现:
数据集                    准确率         损失          耗时
XOR (4 样本)              100.0%      0.0002          6ms
螺旋 (300 样本)           100.0%      0.0248        223ms
高斯簇 (400 样本)         100.0%      0.0004          9ms
线性回归可精确逼近真值:学到 w = 2.511(真值 2.5)、b = -1.2115(真值 -1.2)。
纯 CPU,无 SIMD / 多线程 / WASM(Node v24 · arm64 实测,数值随机器浮动):
| 运算 | 吞吐 |
|---|---|
matmul 512×512 |
2.36 GFLOP/s |
matmul 1024×1024 |
2.30 GFLOP/s |
| MLP 784→128→10 单步(batch 32) | 7.8ms |
坦白说这个数字和 TensorFlow.js 差一个数量级——这是刻意的。数据确实存在 Float64Array 里,但计算是标量 JS 循环:没有 WASM、没有 SIMD、没有算子融合。换来的是每一行都能读懂。你应该用它学习原理,而不是训 ResNet。
以上数字来自 npm run benchmark,可用同一脚本在你的机器上复现。
与其他 JavaScript 框架的适用边界见 对比说明。
| 类别 | 内容 |
|---|---|
| 张量 | Tensor add sub mul div scale matmul softmax relu tanh sigmoid exp log sum mean reshape transpose |
| 采样 | gatherRows concat argmaxLast |
| 卷积 | conv2d(im2col + GEMM)maxPool2d avgPool2d |
| 自动微分 | backward collectLeaves zeroGrad |
| 层 | Linear(He 初始化)Dropout LayerNorm Embedding MultiHeadAttention TransformerBlock Sequential |
| 序列化 | Sequential.toJSON() loadModel(JSON 存档 / 加载) |
| 激活 | relu tanh sigmoid softmax gelu |
| 损失 | crossEntropy mse binaryCrossEntropy accuracy |
| 优化器 | SGD Momentum Adam AdamW RMSProp Scheduler |
| 训练 | Trainer(batch / epoch / 早停 / 历史) |
| 数据集 | makeSpiral makeBlobs makeXor makeLinearRegression |
| 验证 | checkGradient numericalGradient highOrderGradient |
共 57 个导出,114 个测试。
每个算子在前向时把输入快照(_prev)和反向闭包(_backward)挂到输出张量上。backward() 做拓扑排序后逆序执行,保证用到某个张量梯度时它已经算好。
关键区分是 isGraphNode():
isGraphNode() // 我是叶子变量,或我是某个算子的产物中间张量(如 mul 的输出)requiresGrad 是 false——它不是叶子——但它确实在图里。如果用 requiresGrad 判断要不要建图,组合运算的梯度链就会断掉。这个坑 axon 踩过,也修好了(详见 CHANGELOG)。
checkGradient 用有限差分对照解析梯度,同时算一阶和二阶中心差分并逐元素取误差更小者——既能抓住解析梯度的错误,也能排除"数值梯度本身不够准"造成的误判。
完整原理、epsilon 收敛判据和实际抓到的错误见 有限差分梯度校验详解。
// 手写新算子后,这样验证你的梯度公式
const r = checkGradient(() => myOp(a, b).sum(), [a, b]);
if (!r.passed) throw new Error(r.report);这些地方不是"能跑就行",每一个都写明了原因:
softmax先减去行最大值,避免exp溢出crossEntropy用 log-sum-exp 技巧- 指数衰减目标用
0.0001而非0——插值到 0 会抛异常 binaryCrossEntropy把概率 clamp 到[1e-7, 1-1e-7],否则log(0)得到-Infinity,一次越界就让损失变成 NaN
git clone https://github.com/wulier-arch/axon.git
cd axon
npm test          # 114 个用例,无需 npm install
npm run benchmark
本项目零依赖,用 Node 内置的 node:test 而非 Jest。
demo 用了 ES Module,需要经 HTTP 打开(file:// 会被 CORS 拦截):
python3 -m http.server 8000
# 访问 http://localhost:8000/demo/
# 浏览器示例:
# http://localhost:8000/examples/browser/xor.html
# http://localhost:8000/examples/browser/linear-regression.html已完成:层与 Sequential、优化器、损失函数、训练循环、基准测试(v0.2.0),
浏览器端 demo(v0.2.1),LayerNorm、Embedding、MultiHeadAttention、
TransformerBlock(v0.3.0),XOR 与线性回归浏览器示例(v0.3.1);
模型 JSON 序列化与加载、conv2d 批次维度已完成,待随下个版本发布。
当前阶段目标见 ROADMAP.md,工作项见置顶的 v0.4.0 roadmap issue。
- BPE 分词器
- BatchNorm
-
conv2d支持批次维度
欢迎提 Issue 和 PR,见 CONTRIBUTING.md。参与即表示同意 行为准则。
如果你实现了新算子,请务必附上梯度校验用例——这是本项目唯一的质量底线。
MIT © 2026 wulier-arch